CTO の澤田です。
今回は、稼働中のサービスのデータベースで起きていた「RLS(Row Level Security)環境で NUMERIC カラムの検索にインデックスが使われていなかった」という性能問題と、それを解消するために行った 無停止でのカラム型変換(NUMERIC → BIT(160))について解説します。
TL;DR
- RLS が有効なテーブルでは、LEAKPROOF でない演算子はインデックス条件として使えない
NUMERICの比較演算子(numeric_eqなど)は LEAKPROOF ではないため、RLS 下でWHERE serial = $1のような検索がインデックスを使えず、テナント内全行スキャンになる- これを解消するため、シリアル番号カラムを
NUMERICからBIT(160)(比較演算子が LEAKPROOF)へ変換した - 稼働中のサービスを止めずに型変換するため、「型変換専用の中間DB」を挟んだ論理レプリケーション構成を組んだ
背景
弊社は PocketSign Verify という、マイナンバーカードの公的個人認証サービス(JPKI)の電子証明書を検証するサービスを提供しています。マルチテナントのサービスで、テナント間のデータ分離は PostgreSQL の Row Level Security(RLS)で実現しています。
このデータベースの構造を単純化すると、次のようになります。
CREATE TABLE tenants (
    id UUID NOT NULL,
    name TEXT NOT NULL,
    PRIMARY KEY (id)
);

CREATE TABLE certificates (
    tenant_id UUID NOT NULL,
    id UUID NOT NULL,
    serial NUMERIC NOT NULL,  -- ← 問題のカラム
    PRIMARY KEY (id),
    FOREIGN KEY (tenant_id) REFERENCES tenants(id),
    UNIQUE (tenant_id, serial)
);

ALTER TABLE certificates ENABLE ROW LEVEL SECURITY;
CREATE POLICY tenant_only ON certificates
    USING (tenant_id = CURRENT_SETTING('context.tenant_id')::UUID);

-- certificates を参照する子テーブル(検証履歴)
CREATE TABLE verifications (
    tenant_id UUID NOT NULL,
    id UUID NOT NULL,
    certificate_id UUID,
    result TEXT NOT NULL,
    PRIMARY KEY (id),
    FOREIGN KEY (certificate_id) REFERENCES certificates(id)
);
certificates.serial に格納しているのは X.509 証明書のシリアル番号です。シリアル番号は RFC 5280 で最大 20 オクテット(= 160 bit)と定められた巨大な整数で、10進数にすると最大49桁になります。BIGINT(64 bit)には収まらないため、任意精度の整数を格納できる NUMERIC を選んでいました。
RLS と LEAKPROOF の問題
症状: インデックスがあるのに使われない
certificates には UNIQUE (tenant_id, serial) の複合インデックスがあり、シリアル番号での証明書検索クエリはインデックスが使用されることを期待していました。
しかしながら、アプリケーションから実行すると Seq Scan になっていました。
手元の PostgreSQL 18.6 で再現した例です。1000万行のテーブルに対して、アプリケーションと同じ一般ロール(RLS が適用されるロール)でシリアル番号検索を実行すると、下記の結果となります。
=> EXPLAIN ANALYZE SELECT * FROM certificates
   WHERE tenant_id = CURRENT_SETTING('context.tenant_id')::UUID
   AND serial = 123456789012345678901234567890123456789012345678::NUMERIC;

 Gather  (cost=1000.00..208387.62 rows=1 width=58) (actual time=974.950..976.314 rows=0.00 loops=1)
   Workers Planned: 2
   Workers Launched: 2
   ->  Parallel Seq Scan on certificates  (cost=0.00..207387.52 rows=1 width=58)
         Filter: ((tenant_id = (current_setting('context.tenant_id'::text))::uuid)
                  AND (serial = '123456…'::numeric))
         Rows Removed by Filter: 3333333
 Execution Time: 976.453 ms
ユニークインデックスがあるにも関わらず、これが使用されておらず、約1秒かかっています。 データが増えるほど線形に遅くなり、本番環境では深刻な問題となっていました。
原因: numeric_eq は LEAKPROOF ではない
RLS が有効なテーブルへのクエリでは、ポリシーの条件(security qual)が「セキュリティバリア」として扱われ、ユーザーが書いた WHERE 句の条件は、原則としてポリシー条件より先に評価してはならないというルールが適用されます。
なぜか。もし任意の条件をポリシーより先に評価できてしまうと、たとえば「引数の値をエラーメッセージに含めて RAISE する関数」を WHERE 句に仕込むことで、本来見えないはずの行の中身をエラー経由で盗み見ることができてしまうからです。
この原則の例外が LEAKPROOF 指定です。LEAKPROOF な関数とは「副作用がなく、戻り値以外の経路(エラーメッセージ等)で引数の情報を一切漏らさない」とマークされた関数で、これだけがセキュリティバリアを越えて先に評価される(=インデックス条件として使われる)ことを許されます。
そして、各型の比較演算子が LEAKPROOF かどうかはシステムカタログで確認できます。
SELECT p.oid::regprocedure AS func, p.proleakproof
FROM pg_proc p
WHERE p.proname IN ('numeric_eq', 'biteq', 'texteq', 'int8eq', 'uuid_eq', 'byteaeq');
          func           | proleakproof
-------------------------+--------------
 biteq(bit,bit)          | t
 byteaeq(bytea,bytea)    | t
 int8eq(bigint,bigint)   | t
 numeric_eq(numeric,numeric) | f   ← これ
 texteq(text,text)       | t
 uuid_eq(uuid,uuid)      | t
integer や text、uuid の等価比較は LEAKPROOF ですが、NUMERIC の比較関数は等価比較(numeric_eq)は LEAKPROOF ではありません。
つまり先ほどのクエリでは、下記の挙動となります。
tenant_id = ...はポリシー条件そのものなので評価できる(ただし1テナントの行が大半を占める場合、絞り込みには効かない)serial = ...は LEAKPROOF でないため、インデックス条件に使えず、ポリシー適用後の Filter としてしか評価できない
結果、テナント内全行スキャンになっていたようです。
ちなみに、この「RLS と LEAKPROOF でない演算子」という組み合わせの問題は NUMERIC に限った話ではなく、弊社プロダクトの「ポケットサイン防災」でも TEXT カラムに対する LIKE 演算子(これも LEAKPROOF ではありません)で同様の問題を踏んでいました。そちらの調査と対処については別の記事「RLSが有効なテーブルにおけるクエリ高速化の取り組み」で解説しているので、あわせてご覧ください。
罠: オーナーで試すと再現しない
この問題のたちが悪いところは、テーブルオーナーや superuser で EXPLAIN しても再現しないことです。 RLS はデフォルトではテーブルオーナーに適用されないため、同じクエリでも結果が異なります。
(オーナーで実行)
 Index Scan using certificates_tenant_id_serial_key on certificates
   Index Cond: ((tenant_id = ...) AND (serial = '123456…'::numeric))
 Execution Time: 0.080 ms
このように、何事もなくインデックスが使われます。「psql から試すと速いのにアプリ経由だと遅い」という現象の原因がこれでした。性能検証は必ずアプリケーションと同じ権限のロールで行う必要があります(後述のベンチマークでも SET ROLE を使っています)。
解決策: 比較演算子が LEAKPROOF な型へ変換する
原因が型の性質にある以上、対処は型を変えることです。シリアル番号は「最大 160 bit の識別子」であって数値演算の対象ではないので、上限サイズちょうどの固定長ビット列 BIT(160) を採用しました。biteq / bitcmp は LEAKPROOF なので、RLS 下でもインデックス条件に使えます(BYTEA の byteaeq も LEAKPROOF なので、バイト列として持つ選択肢もあります)。
同じ 1000 万行・同じ RLS 構成で、型だけ BIT(160) に変えると、下記の結果となります。
 Index Scan using certificates_tenant_id_serial_key on certificates
   Index Cond: ((tenant_id = ...) AND (serial = '0000…'::bit(160)))
 Execution Time: 0.048 ms
インデックスが想定通り正しく使われるようになり、1秒近くかかっていたクエリが1ミリ秒以下で処理されるようになりました。
補足: ALTER FUNCTION ... LEAKPROOF ではダメなのか
「numeric_eq を自分で LEAKPROOF にマークすればいいのでは?」という案も実際に検討しました。技術的には superuser で ALTER FUNCTION numeric_eq(numeric, numeric) LEAKPROOF を実行できます。しかし本件のサービスではマネージドデータベースサービスを利用しており、superuser 権限が与えられていないため、そもそもこの変更は実行できませんでした。
仮に実行できたとしても、「この関数は情報を漏らさない」という PostgreSQL 開発チームが与えていない保証を自分で引き受けることになる上、等価比較だけでなく大小比較など関連演算子一式に同じ措置が必要になるため、筋の良い解決策とは言えません。
無停止でカラムタイプを変換する方法の検討
スロークエリの原因が特定できたところで、具体的なカラムタイプ変換方法を検討しました。 対象は稼働中の本番データベースで、サービスの性質上、長時間の停止は受け入れられず、無停止での変換が必要です。
案1: ALTER TABLE ... ALTER COLUMN ... TYPE
ALTER TABLE certificates ALTER COLUMN serial TYPE BIT(160) USING numeric_to_bit160(serial);
一見これで済みそうですが、型変換を伴う ALTER COLUMN はテーブル全体の書き換えが発生する場合があり、その間 ACCESS EXCLUSIVE ロックでテーブルへの読み書きが一切ブロックされるため、データ量に比例した長さのダウンタイムが発生します。
また、そもそも組み込みの機能では NUMERIC の列を BIT(160) の列へ直接変換することはできず、採用できませんでした。
案2: pg_dump → 変換 → リストア
ダンプを加工して新スキーマへ流し込む方法です。任意の変換ができますが、ダンプ取得からリストア完了までの間に発生した書き込みを追いつかせる手段がなく、結局その間サービスを止めることになります。これもデータ量に比例して停止時間が伸びてしまいます。
案3: 素の論理レプリケーション
PostgreSQL の論理レプリケーションは、稼働中のDBから別のDBへ「初期データの全件コピー+以降の変更の継続的な追従」が可能で、無停止移行の有力な手段です。
しかし、subscriber 側のテーブルは publisher 側と互換の型でなければならず、レプリケーションの途中に行の変換処理を挟むことはできません。
NUMERIC の列を BIT(160) の列へ直接流すことは、そもそも不可能でした。
案4: アプリケーションでのダブルライト
アプリが新旧両方のDBへ書き込む方式も検討しましたが、アプリの改修範囲が広く、片系書き込み失敗時の整合性担保を考える必要があるなど、移行コストが高いと考え、見送りました。
案5: pgroll
pgroll は、PostgreSQL の無停止スキーマ変更を実現する OSS ツールです。専用ビューから旧テーブルにアクセスさせつつ、トリガーによるダブルライト、バックフィルをしつつ、ビューの裏にいるテーブルを切り替えるという一連の処理を自動化してくれるものです。型変更の変換ロジックは up / down に SQL 式として書けるため、後述する numeric_to_bit160() のような複雑な型変換も可能です。カラムのリネームにも対応しており、機能面では今回の要件を完全に満たしていました。
pgroll では、アプリケーションは専用ビュー越しにテーブルへアクセスすることになり、マイグレーションの適用・完了のライフサイクルも pgroll が管理します。弊社では既に別のマイグレーションツールで運用が回っており、「今回の型変換のときだけ pgroll を使う」という一時利用は難しく、採用するならマイグレーション運用全体を pgroll のモデルへ切り替える必要がありました。今回のカラムタイプ変換のためだけに運用フローを刷新することは避けたく、見送りました。
pgroll 自体は素晴らしいツールであり、新規プロジェクトなら最初から採用を検討したい選択肢です。
採用: 論理レプリケーション + postgres_fdw
論理レプリケーションの自動追従機能のメリットは得ながら、データの変換を行うために、変換だけを担当する中間DBを1台挟むという方法を取りました。 中間DBは、論理レプリケーションで古いスキーマのデータを受け取り、新しいスキーマに変換しつつ postgres_fdw で新DBにデータを送信します。
postgres_fdw は、外部の PostgreSQL サーバーに存在するテーブルを、あたかもそのサーバー内にある通常のテーブルかのように扱うことができるデータラッパです。 通常のテーブルへの操作と同じ感覚で、外部サーバーにデータを送信できる便利なモジュールです。
無停止でのカラムタイプ変換をどう実現したか
全体構成
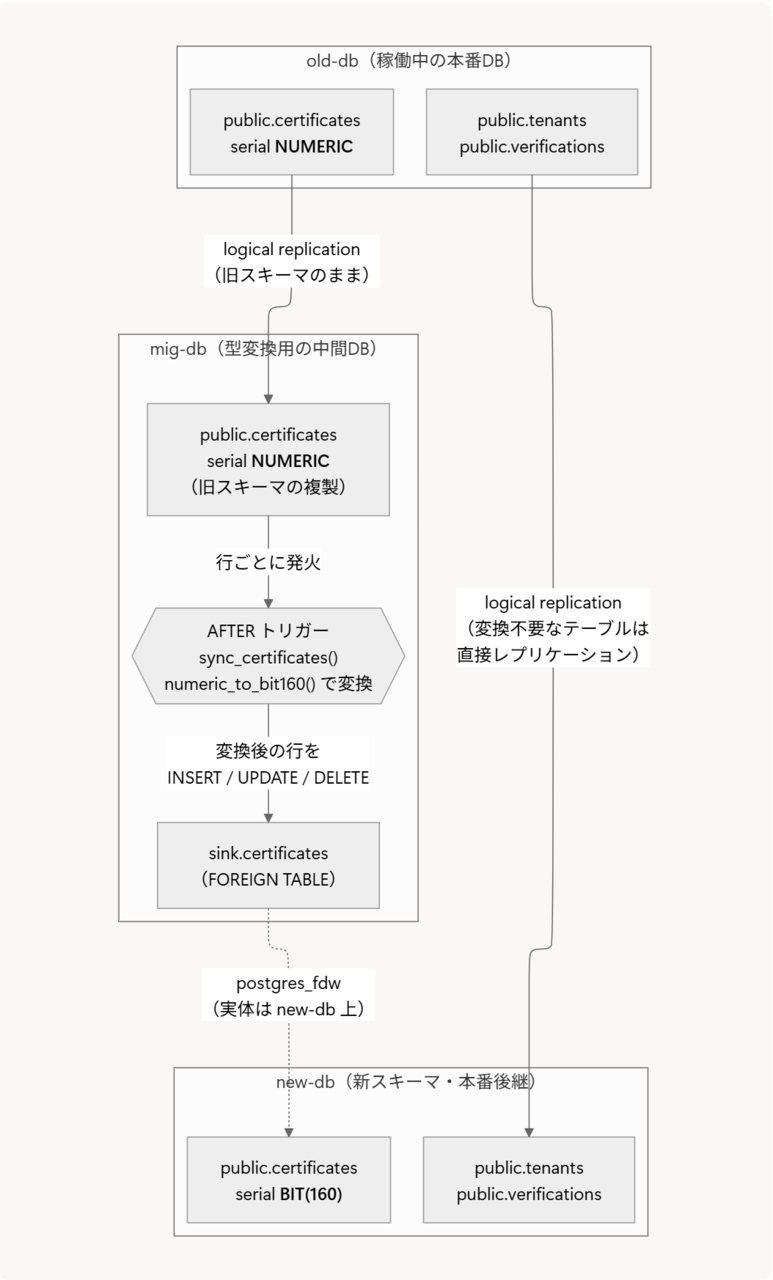
登場するDBは3つです。
| DB | 役割 |
|---|---|
old-db |
移行元。稼働中の本番DB |
mig-db |
型変換用の中間DB。旧スキーマと同じ形のテーブルを持ち、トリガーで変換して新DBへ転送する |
new-db |
移行先。新スキーマの本番DB |
テーブルを2種類に分けます。
- 変換が不要なテーブル(
tenants,verifications):old-db→new-dbへ素の論理レプリケーションで直接流す - 変換が必要なテーブル(
certificates):old-db→mig-dbへレプリケーションし、mig-db上の AFTER トリガーが行を変換して、postgres_fdwの FOREIGN TABLE 経由でnew-dbへ書き込む
この構成の利点は、論理レプリケーションに関する設定が済んでいれば、稼働中の本番DBには PUBLICATION を作るのみで良いことです。トリガーも変換関数も本番には載らず、変換の負荷はすべて mig-db が引き受けます。mig-db は移行が終わったら捨てるだけです。
以下、実際の手順を5ステップで見ていきます(検証は Docker Compose で3つのDBを立てて行いました)。
Step 1: old-db で PUBLICATION を作成する
テーブルごとに PUBLICATION を分けて作ります。1つにまとめないのは、後述の通り SUBSCRIPTION の作成順序=初期コピーの順序を外部キー制約に合わせて制御するためです。
-- 変換不要(new-db へ直接)
CREATE PUBLICATION tenants_pub FOR TABLE "public"."tenants";
CREATE PUBLICATION verifications_pub FOR TABLE "public"."verifications";

-- 要変換(mig-db 経由)
CREATE PUBLICATION certificates_pub FOR TABLE "public"."certificates";
Step 2: mig-db に「旧スキーマのままの」受け皿テーブルを作成する
mig-db には、旧スキーマと同じ形のテーブルを作ります。論理レプリケーションをそのまま受けるだけなので、serial は NUMERIC のままです。RLS やインデックスは不要で、カラム構成だけ合っていれば十分です。
CREATE TABLE "public"."certificates" (
    "tenant_id" uuid NOT NULL,
    "id" uuid NOT NULL,
    "serial" numeric NOT NULL,   -- 旧スキーマのまま受ける
    PRIMARY KEY ("id")
);
Step 3: new-db への書き込み口を postgres_fdw で用意する
変換後の行の送り先として、new-db のテーブルを FOREIGN TABLE としてインポートします。
CREATE EXTENSION IF NOT EXISTS "postgres_fdw";
CREATE SCHEMA IF NOT EXISTS "sink";

CREATE SERVER "main_server"
FOREIGN DATA WRAPPER "postgres_fdw"
OPTIONS (host 'new-db', port '5432', dbname 'app', batch_size '1000');

CREATE USER MAPPING FOR CURRENT_USER
SERVER "main_server"
OPTIONS (user 'postgres', password '********');

IMPORT FOREIGN SCHEMA "public" LIMIT TO ("certificates")
FROM SERVER "main_server" INTO "sink";
Step 4: 変換トリガーを仕込む
PostgreSQL には NUMERIC を直接ビット列にする組み込み手段はないため、まず NUMERIC → BIT(160) の変換関数を定義します。
63 bit ずつのチャンクに分割して to_bin() で2進文字列化し、160 bit にゼロ埋めして連結する関数を書きました。
CREATE OR REPLACE FUNCTION public.numeric_to_bit160(n NUMERIC)
RETURNS BIT(160) AS $$
DECLARE
    num NUMERIC := n;
    bin_str TEXT := '';
    chunk_size CONSTANT NUMERIC := POWER(2::NUMERIC, 63);
BEGIN
    WHILE num > 0 LOOP
        bin_str := lpad(to_bin(mod(num, chunk_size)::BIGINT), 63, '0') || bin_str;
        num := div(num, chunk_size);
    END LOOP;
    RETURN right(repeat('0', 160) || bin_str, 160)::BIT(160);
END;
$$ LANGUAGE plpgsql IMMUTABLE;
そして、INSERT / UPDATE / DELETE を sink スキーマの FOREIGN TABLE へ転送する AFTER トリガーを各テーブルに設定します。
CREATE OR REPLACE FUNCTION public.sync_certificates()
RETURNS TRIGGER AS $$
BEGIN
    IF TG_OP = 'INSERT' THEN
        INSERT INTO "sink"."certificates" (tenant_id, id, serial)
        VALUES (NEW.tenant_id, NEW.id, public.numeric_to_bit160(NEW.serial));  -- ここで型変換
        RETURN NEW;
    ELSIF TG_OP = 'UPDATE' THEN
        UPDATE "sink"."certificates"
        SET
            tenant_id = NEW.tenant_id,
            id = NEW.id,
            serial = public.numeric_to_bit160(NEW.serial)
        WHERE id = OLD.id;
        RETURN NEW;
    ELSIF TG_OP = 'DELETE' THEN
        DELETE FROM "sink"."certificates" WHERE id = OLD.id;
        RETURN OLD;
    END IF;
END;
$$ LANGUAGE plpgsql;

CREATE TRIGGER sync_certificates_trigger
AFTER INSERT OR UPDATE OR DELETE ON "public"."certificates" FOR EACH ROW
EXECUTE FUNCTION public.sync_certificates();
型変換に限らず、テーブル名・カラム名の変更や値のマッピング、導出値の計算など、新旧スキーマの差分はすべてこのトリガー層で吸収できます。 実際の移行では、この機会に溜まっていたスキーマの負債(リネームや値の持ち方の見直し)もまとめて解消しました。
罠: 論理レプリケーションで作成された行に対するトリガーの挙動
トリガーを作っただけでは、レプリケーションで届いた行に対してトリガーは発火しませんでした。
論理レプリケーションの apply worker は session_replication_role = replica で動作するため、通常のトリガー(実体は ENABLE TRIGGER ORIGIN)は無効化されるようです。
-- これをしないとレプリケーション経由ではトリガーが動かない
ALTER TABLE "public"."certificates" ENABLE ALWAYS TRIGGER sync_certificates_trigger;
これを忘れると、レプリケーション自体は正常に流れているのに new-db には1行も届かない、エラーも出ないという状態になります。
Step 5: SUBSCRIPTION を外部キーの依存順に作成する
SUBSCRIPTION を作成すると初期コピー(既存データの全件コピー)が始まり、以降の変更が継続的に送信されます。ここで重要なのが作成の順序です。new-db 側には外部キー制約があるため、参照される側からコピーしないと初期コピーが制約違反で失敗します。
また、各段階で pg_subscription_rel.srsubstate = 'r'(初期コピーが終わっており、通常のレプリケーションモードに移行していること)を確認する必要があります。
今回の例では、下記の順番としました。
tenants— すべての親。new-dbで直接 SUBSCRIBEcertificates—tenantsを参照。mig-dbで SUBSCRIBE(トリガー経由でnew-dbへ)verifications—certificatesを参照するため最後。new-dbで直接 SUBSCRIBE
-- mig-db 上で
CREATE SUBSCRIPTION certificates_sub
CONNECTION 'host=old-db dbname=app user=replicator password=********'
PUBLICATION certificates_pub;
Step 1 でテーブルごとに PUBLICATION を分けたのは、この順序制御を「SUBSCRIPTION を作るタイミング」だけで実現するためです。
本番切り替え
レプリケーションが追いついた状態を確認した上で、新スキーマに対応し new-db へ接続するアプリケーションコンテナをデプロイし、旧コンテナと置き換えるという方法で切り替えました。
レプリケーション状態の確認
切り替え前に、すべてのテーブルで初期コピーが完了し、以降の変更が継続的に適用される状態(通常のレプリケーションモード)に入っていることを確認する必要があります。これは subscriber 側(new-db と mig-db)のシステムカタログ pg_subscription_rel で確認できます。
SELECT srrelid::regclass AS table_name, srsubstate
FROM pg_subscription_rel;
srsubstate はテーブルごとの同期状態を表し、i(初期化中)→ d(初期データのコピー中)→ f(テーブルコピー完了)→ s(同期済み)と遷移し、最終的に r(ready: 通常のレプリケーションで継続追従中)となります。
すべてのテーブルの srsubstate が r になっていることを確認できたら、切り替え可能な状態です。
切り替え時のリスク
コンテナの置き換えはローリングアップデートで行われるため、旧コンテナ(old-db に書き込む)と新コンテナ(new-db に書き込む)が同時に存在する時間帯が発生します。この間、new-db には「旧コンテナ → old-db → mig-db 経由で転送されてくる書き込み」と「新コンテナからの直接の書き込み」の2系統が同時に流れ込み、これらは衝突し得ます。
具体的には次のようなことが起こり得ます。
- 一意制約違反によるレプリケーションの停止: 旧経路と新経路が同じキー(同一シリアル番号の証明書など)を INSERT すると、後から届いた側が一意制約違反になります。これがレプリケーション適用側で起きると、apply worker はエラーで停止・再試行を繰り返し、該当 SUBSCRIPTION のレプリケーション全体が詰まります
- 読み取りの一時的な不整合: 旧コンテナ経由で書き込まれたデータが
new-dbに反映されるまでにはレプリケーションのラグがあるため、新コンテナからは「書いたはずのデータがまだ見えない」瞬間があり得ます
今回は、切り替えの所要時間が短いことと、対象サービスの書き込みパターン上、同一データへの書き込みが極めて短い時間窓で競合する可能性が低いことから、このリスクは許容した上で、リクエストが最も少ない時刻に切り替えを実施するという判断をしました。結果として、特に問題は発生せず切り替えは無事完了しました。
これらのリスクを厳密に排除したい場合は、切り替えの瞬間だけ書き込みを止める(メンテナンスモード等)ことが避けられません。 無停止とこのリスク排除はトレードオフになるため、サービスの特性に応じて許容できるリスクかどうかを判断する必要があります。
また、当然 new-db 側に直接書き込まれたデータは old-db には連携されないため、一度切り替えを行うと戻すことは難しい点も注意が必要です。
まとめ
- RLS 環境では、比較演算子が LEAKPROOF でない型(
NUMERICなど)のカラム検索はインデックスが使われない。性能検証は必ずアプリと同じ権限のロールで行うこと - 大きな識別子には、演算用の
NUMERICではなく、比較演算子が LEAKPROOF なBIT(n)やBYTEAを検討する - 論理レプリケーションは型変換できないが、旧スキーマの形をした中間DBを挟み、トリガー +
postgres_fdwで変換しながら転送すれば、無停止の型変換・リネーム・データ変換が PostgreSQL 標準機能だけで実現できる - 中間DB方式なら稼働中の本番DBに載せる変更は PUBLICATION のみで、リスクを局所化できる
- ハマりどころは
ENABLE ALWAYS TRIGGERと SUBSCRIPTION の作成順序 - ローリングでの接続先切り替えには新旧経路の書き込み競合リスクがある。許容できるかを書き込みパターンから見極め、実施する場合は低トラフィック時間帯にする
We’re hiring!
ポケットサインでは、今回のような課題に向き合い、堅牢なサービスを一緒に作っていくエンジニアを募集しています。 マイナンバーカードを活用したサービスで地域社会を支える、やりがいのある仕事です。
少しでも興味を持っていただけた方は、ぜひ採用情報ページをご覧ください。
